Deine Reise zum digitalen Erfolg


Ein separates Memory-System kann KI-Coding-Agenten genau das Projektwissen bereitstellen, das sie für eine Aufgabe brauchen, statt den gesamten Verlauf oder alle Dokumente in jede Anfrage zu laden. Die Ergebnisse meiner Masterarbeit, die in Kooperation mit fellowork entstanden ist, deuten darauf hin, dass dies Konsistenz, Testabdeckung und die Erfolgsquote beim ersten Lösungsversuch verbessern kann. Voraussetzung sind jedoch gute Wissensqualität, klare Zugriffsrechte und menschliche Kontrolle.
Ein Sprachmodell verarbeitet Informationen innerhalb eines begrenzten Kontextfensters. Das ist der Textbereich, den das Modell bei einer Anfrage gleichzeitig berücksichtigen kann: aktuelle Anweisungen, Gesprächsverlauf, Dateien, Tool-Ergebnisse und weitere Inhalte.
Mit jeder Nachricht, Datei und Tool-Antwort wächst dieser Kontext. Ältere Informationen können an Gewicht verlieren oder aus dem verfügbaren Kontext herausfallen. Große Kontextfenster verschieben diese Grenze, lösen aber nicht das grundsätzliche Problem: Es ist weder sinnvoll noch zuverlässig, sämtliche Dokumente, Entscheidungen und vergangenen Gespräche bei jeder Anfrage mitzuschicken.
Zu viel Kontext erschwert die Arbeit des Agenten. Wichtige Regeln gehen zwischen weniger relevanten Informationen unter, Anfragen werden aufwendiger, und der Agent erkennt schlechter, welche Information für die aktuelle Aufgabe wirklich zählt.
Ein KI-Agent braucht nicht möglichst viel Kontext. Er braucht den richtigen Kontext zur richtigen Zeit.
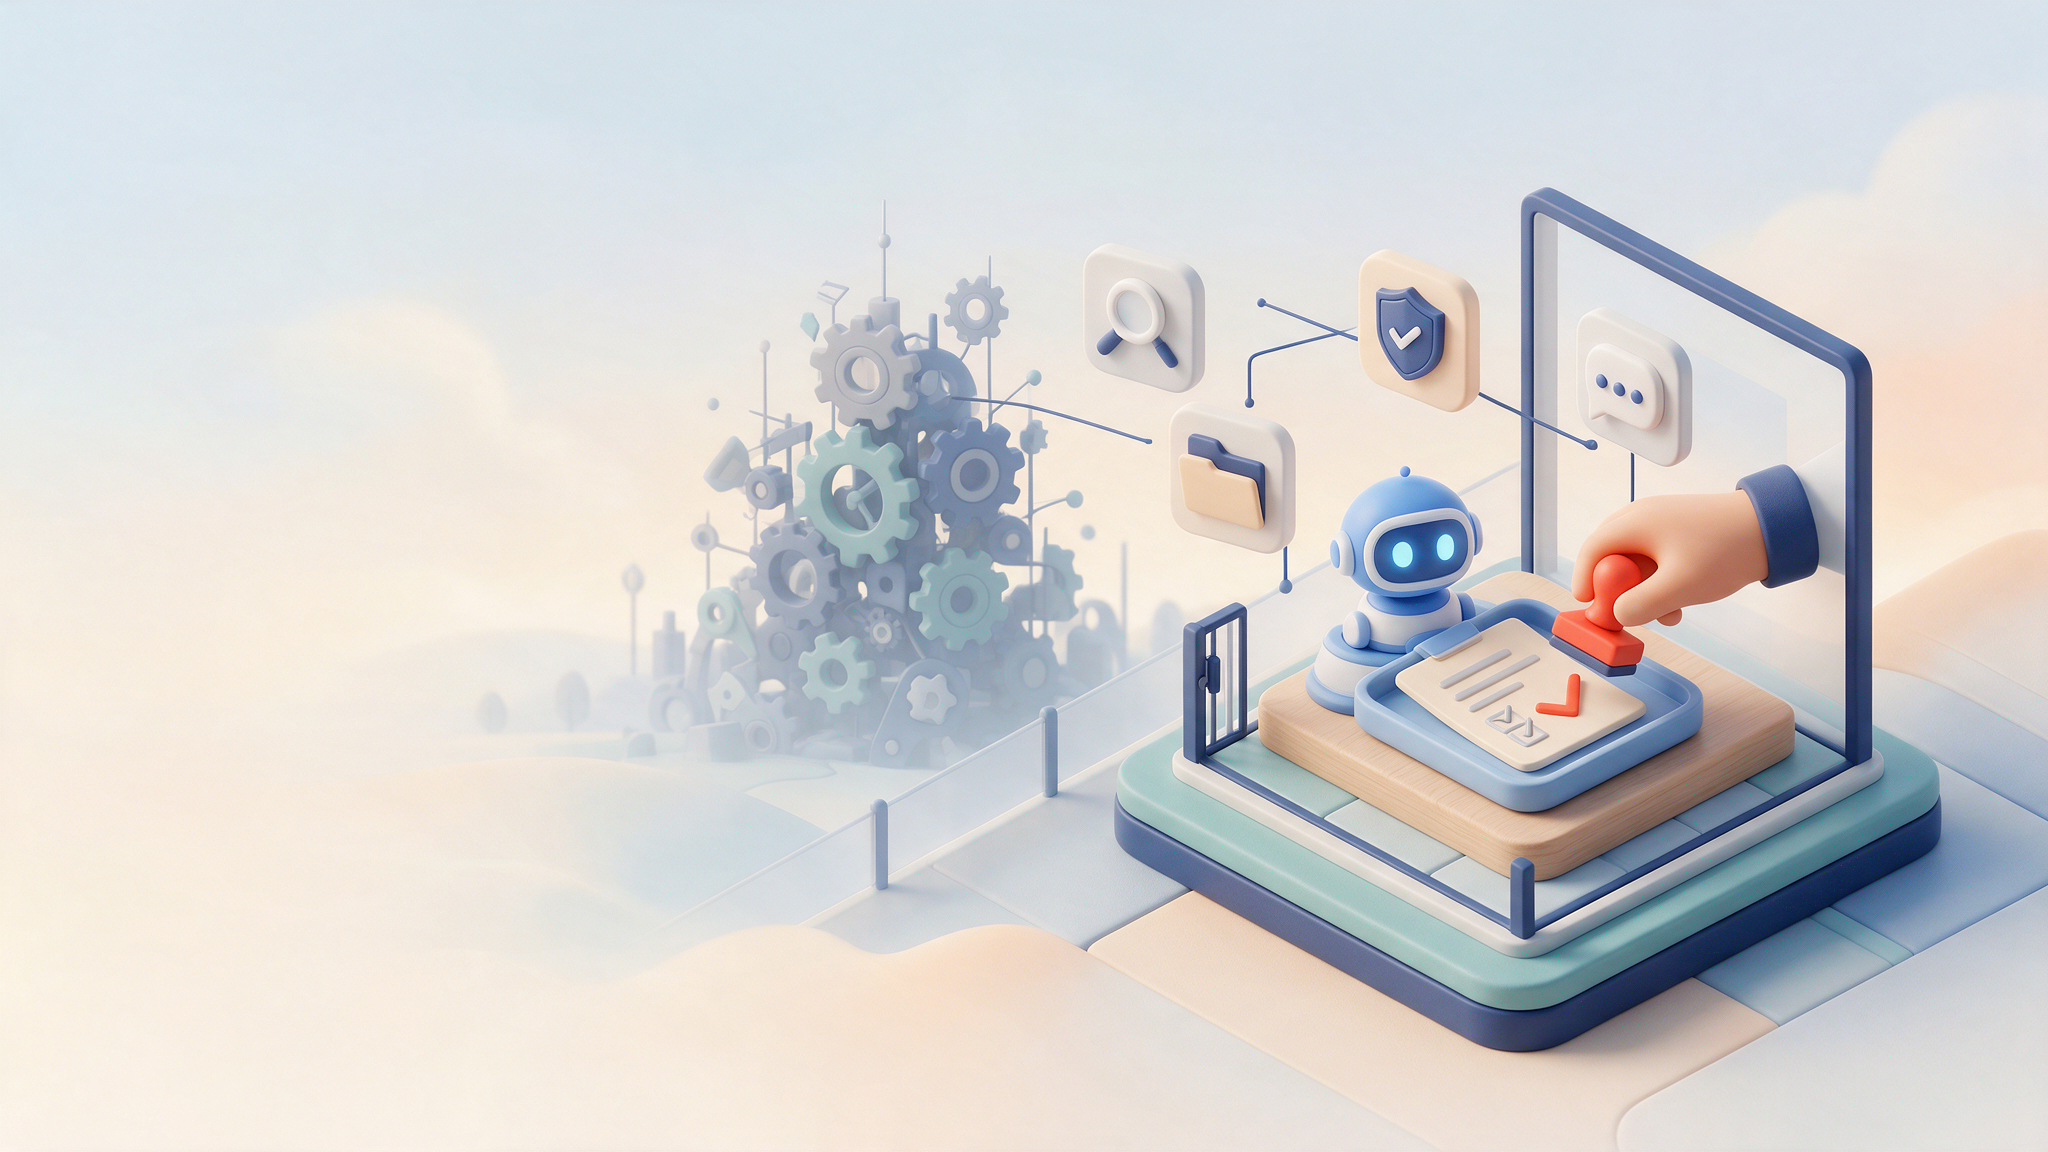
Ein Memory-System trennt deshalb die langfristige Wissenshaltung von der aktuellen Aufgabenbearbeitung. Der Agent erhält keinen vollständigen Datenbestand, sondern einen passenden Ausschnitt.
In der entwickelten Architektur werden drei Arten von Informationen getrennt. Das ist wichtig, weil sie unterschiedliche Gültigkeit haben, aus unterschiedlichen Quellen stammen und unterschiedlich gepflegt werden müssen.
Das Kurzzeitgedächtnis umfasst den Gesprächsverlauf und Arbeitsnotizen des Agenten. Dazu gehören Zwischenergebnisse, bereits geprüfte Dateien oder offene Fragen. Diese Informationen helfen dem Agenten, eine laufende Aufgabe nachvollziehbar fortzuführen, müssen aber nicht dauerhaft in eine Wissensbasis überführt werden.
Beispiel: Bei der Fehlersuche in einer Anwendung kann der Agent festhalten, welche Komponenten bereits untersucht wurden. Diese Notiz verhindert doppelte Arbeit, ist aber keine dauerhaft gültige Projektregel.
Projekt- und Fachwissen umfasst Informationen, die für ein bestimmtes Team oder Projekt gelten. Dazu können Architekturentscheidungen, Schnittstellen, Coding-Konventionen, eingesetzte Technologien, fachliche Begriffe und Vorgaben für Tests oder Sicherheit gehören.
Gerade dieses Wissen ist in Unternehmen oft verteilt: in Projektdateien, Wikis, Tickets, Dokumentationen und in den Köpfen einzelner Personen. Ein Agent, der es gezielt abrufen kann, muss weniger Annahmen treffen und kann sich besser an bestehende Entscheidungen halten.
Das Langzeitgedächtnis speichert Informationen, die über einzelne Sitzungen hinweg gelten, etwa technische Präferenzen oder wiederkehrende Arbeitsweisen. Dabei ist Zurückhaltung entscheidend. Nicht jede Aussage aus einem Chat ist eine dauerhafte Wahrheit und nicht jede Beobachtung sollte als verbindliche Regel gespeichert werden.
Für den Abruf nutzt das System einen hybriden Ansatz nach dem Prinzip von GraphRAG. Das Grundprinzip dahinter heißt RAG (Retrieval-Augmented Generation): Die KI schlägt relevantes Wissen nach, bevor sie antwortet. GraphRAG verbindet dieses Nachschlagen mit einem Wissensgraphen. Die semantische Suche findet Inhalte anhand ihrer Bedeutung. Der Wissensgraph ergänzt sie um die Beziehungen zwischen Informationen.
Vereinfacht kann das System erkennen, dass eine Anfrage zur Anmeldung an einer Schnittstelle mit Informationen zu Zugriffsrechten oder Login-Abläufen zusammenhängt, auch wenn nicht überall dieselben Begriffe verwendet werden. Der Graph kann zusätzlich abbilden, zu welchem Projekt eine Schnittstelle gehört, welche Architekturentscheidung sie betrifft oder welche Regel für sie gilt.
Der Ablauf besteht aus vier Schritten:
Das Ergebnis ist ein adaptiver Kontext: Er wird nach Relevanz für die aktuelle Aufgabe zusammengestellt, nicht allein nach Aktualität. In der Masterarbeit setzt er sich aus vier Bausteinen zusammen.
Baustein
Inhalt
Memories
Langzeitsfakten aus der bisherigen Interaktion des Agenten
Knowledge
Wissen aus der Wissensbasis des Teams oder Unternehmens
Entities
Passende Einträge im Wissensgraphen und ihre Verbindungen
Insights
Übergeordnete Zusammenfassungen zu einem Thema
Diese Bausteine greifen auf Langzeitgedächtnis und Projektwissen zu und ergänzen sie um Verbindungen aus dem Wissensgraphen und thematische Zusammenfassungen. Das Kurzzeitgedächtnis bleibt bei der laufenden Aufgabe.
Ein Memory-System ist nur dann nützlich, wenn es nicht ungeprüft falsche, doppelte oder veraltete Aussagen ansammelt. Deshalb werden neue Informationen in zwei Schritten verarbeitet.
Zuerst schlägt ein Sprachmodell (das „Extraktionsmodell“) mögliche Fakten aus Nachrichten oder Arbeitsergebnissen vor, zum Beispiel eine neue Regel für Schnittstellen oder eine beschlossene Testkonvention.
Dann prüft ein zweites Modell (das „Supervisor-Modell“) diese Vorschläge gegen den relevanten Ausschnitt des vorhandenen Wissensgraphen. Es kann einen Fakt übernehmen, ablehnen, anpassen oder mit einem bestehenden Eintrag zusammenführen.
Entscheidend ist, dass diese Prüfung nicht nur den neuen Vorschlag für sich betrachtet. Durch den Abgleich mit zusammenhängendem Wissen erkennt das System Doppelungen und Widersprüche, bevor es Informationen dauerhaft speichert.
Die Verarbeitung läuft asynchron, also im Hintergrund, nachdem die aktuelle Interaktion gespeichert wurde. Der Agent kann eine Aufgabe weiterbearbeiten, während neue Fakten geprüft werden. Die Pflege des Memory-Systems blockiert damit nicht die eigentliche Arbeit.
Die Masterarbeit verglich einen mehrstufigen Workflow aus Anforderungs-, Coding- und Feedback-Agent jeweils mit und ohne Memory-System. In der ersten Testreihe erstellte der Workflow kleine Webanwendungen. Bewertet wurden Codequalität, Testabdeckung (der Anteil des Codes, der automatisch getestet wird) und die Einschätzung von sieben Testpersonen. In der zweiten Testreihe bearbeitete der Agent zwanzig Programmieraufgaben aus der KIT Programmieren Modul, die automatisiert ausgewertet wurden.
Die Ergebnisse gelten für den verwendeten Testaufbau und sind keine allgemeine Garantie für jedes Modell, Team oder Projekt. Sie zeigen jedoch drei deutliche Tendenzen:
Die durchschnittliche Bearbeitungszeit war mit Memory-System etwas höher: 32 Minuten gegenüber 27 Minuten ohne Memory-System. Das Memory-System führte in diesem Vergleich also nicht zu einer Beschleunigung, sondern zu einer leichten Verlangsamung. Sein Nutzen zeigte sich vor allem darin, dass der Agent häufiger direkt zu einem brauchbaren und projekttauglichen Ergebnis kam.
Es gab auch Gegenbeispiele. Bei einigen ungewöhnlichen Aufgaben benötigte der Agent mit Memory-System mehr Korrekturrunden. Eine mögliche Erklärung ist, dass er sich zu stark an einer frühen, auf gespeichertem Wissen beruhenden Annahme orientierte. Das zeigt eine wichtige Grenze: Das System muss Wissen bereitstellen, ohne den Agenten auf eine nicht passende Lösung festzulegen.
Die Ergebnisse der Masterarbeit sind für uns bei fellowork ein Anlass, den Ansatz weiterzuverfolgen. Wir möchten das Memory-System als Baustein in unsere Coding-Agent-Infrastruktur integrieren, damit Agenten projektspezifisches Wissen kontrolliert abrufen und über Aufgaben hinweg berücksichtigen können.
Dabei steht keine flächendeckende Einführung am Anfang. Zunächst wollen wir die Integration an klar abgegrenzten Workflows erproben und anhand überprüfbarer Kriterien bewerten. Entscheidend ist, ob der zusätzliche Kontext die Qualität und Konsistenz der Ergebnisse verbessert und ob der Nutzen die etwas höhere Bearbeitungszeit im Testaufbau rechtfertigt.
Der Maßstab für diese Weiterentwicklung ist nicht die Menge gespeicherter Informationen. Für uns ist entscheidend, ob Coding-Agenten im Arbeitsalltag nachvollziehbarere, konsistentere und für Teams besser übernehmbare Ergebnisse liefern.
Ein Memory-System verarbeitet projektbezogenes und potenziell sensibles Wissen. Damit es Teil einer produktiven Coding-Agent-Infrastruktur werden kann, müssen technische Qualität, klare Regeln und Zuständigkeiten sowie Sicherheit von Anfang an zusammen gedacht werden.
Die aktuelle Architektur löst diese Punkte noch nicht vollständig. Eine feingranulare Steuerung von Sichtbarkeit und Berechtigungen sowie ein automatischer Bereinigungsmechanismus für veraltete Einträge sind zentrale nächste Entwicklungsschritte. Diese Anforderungen wollen wir bei der weiteren Integration von Anfang an berücksichtigen, statt sie erst nachträglich an eine bestehende Agenten-Infrastruktur anzubauen.
Ein Memory-System löst keine unklaren Anforderungen und ersetzt keine fachliche Prüfung. Es kann jedoch eine praktische Lücke schließen: KI-Coding-Agenten erhalten Projektwissen, Regeln und relevante Zusammenhänge gezielt dort, wo sie sie für eine Aufgabe benötigen.
Die Ergebnisse meiner Masterarbeit deuten darauf hin, dass der Ansatz besonders bei Konsistenz, Testqualität und dem ersten Lösungsversuch helfen kann. Für Teams, die KI-Coding-Agenten bereits einsetzen, ist ein begrenzter Testlauf mit gut dokumentiertem Projektwissen daher ein pragmatischer nächster Schritt.
Nein. Ein sinnvoller Ansatz speichert nicht pauschal alles, sondern extrahiert relevante Informationen und prüft sie vor der Übernahme. Zudem sollte klar geregelt sein, welche Daten verarbeitet werden dürfen und wie lange sie gespeichert bleiben.
Eine Regeldatei bleibt wichtig, reicht allein aber oft nicht aus. Sie kann verbindliche Vorgaben enthalten, bildet aber nicht automatisch Beziehungen zu Architekturentscheidungen, Fachwissen oder früheren Erkenntnissen ab. Ein Gedächtnis-System kann solche Informationen passend zur Aufgabe ergänzen, sollte die verbindliche Dokumentation aber nicht ersetzen.
Nein. Bei einem kleinen, klaren Wissensbestand kann eine einfachere Suche ausreichen. Ein graphbasierter Ansatz wird vor allem dann interessant, wenn Wissen aus vielen verbundenen Systemen, Projekten und Entscheidungen besteht und diese Beziehungen für die Aufgabe relevant sind.
Ja, dieses Risiko besteht. Wenn falsche oder veraltete Informationen gespeichert werden, kann ein Agent sie erneut verwenden. Prüfung, Quellenbezug, Berechtigungen und eine regelmäßige Bereinigung sind deshalb Bestandteile eines belastbaren Konzepts.